Cómo Perplexity busca y cita sus fuentes
·
Quint-Ia Vantage
Perplexity encuentra fuentes con su propio rastreador, PerplexityBot, y obtiene páginas en tiempo real con un segundo agente, Perplexity-User, cuando alguien hace una pregunta. Cada respuesta incluye enlaces de retorno a las páginas que utilizó. Esto convierte a Perplexity en el motor de respuestas más transparente de los principales que existen (herramientas de IA como ChatGPT, Gemini y Perplexity que responden con una respuesta escrita en lugar de una lista de enlaces), y en el que su trabajo de búsqueda existente se transfiere de forma más directa.
Cada motor de respuestas recupera y cita el contenido de manera diferente, por lo que una sola cifra de "visibilidad de IA" oculta la mayor parte de lo que realmente importa. El comportamiento de Perplexity se asemeja más al de un motor de búsqueda tradicional que cualquiera de los demás.
Este artículo explica cómo funciona la recuperación de información de Perplexity, utilizando la propia documentación del rastreador de Perplexity y un estudio de citas de 15.000 consultas realizado por Ahrefs, y lo que esto significa para su contenido.
¿Utiliza Perplexity el índice de Google o de Bing?
No. Perplexity cuenta con su propio rastreador, PerplexityBot, que recopila e indexa páginas para poder mostrarlas y enlazarlas en las respuestas de Perplexity [1]. Ahrefs también señala que Perplexity mantiene su propio rastreador de búsqueda en lugar de depender de Google o Bing [2].
Perplexity declara que PerplexityBot no se utiliza para recopilar contenido para el entrenamiento de modelos de lenguaje base de IA [1]. Su función es la búsqueda: encontrar páginas que se puedan mostrar y enlazar en una respuesta.
Esto tiene una consecuencia práctica. Si su archivo robots.txt (el archivo que indica a los rastreadores qué páginas pueden visitar) bloquea a PerplexityBot, es poco probable que sus páginas aparezcan en los resultados de búsqueda de Perplexity. La documentación de Perplexity recomienda permitirlo y publica los rangos de IP del bot para que pueda verificar el tráfico real que proviene de él [1].
¿Cómo cita Perplexity las fuentes en tiempo real?
Cuando un usuario hace una pregunta, Perplexity puede enviar un segundo agente, Perplexity-User, para visitar páginas web en el acto e incluir enlaces a ellas en la respuesta [1]. La respuesta se basa en las páginas obtenidas en el mismo momento en que se formula la pregunta.
Perplexity-User actúa en nombre de una persona, por lo que Perplexity afirma que, por lo general, ignora las reglas del archivo robots.txt [1]. Al igual que PerplexityBot, no se utiliza para recopilar contenido para el entrenamiento de modelos.
Los dos agentes se dividen el trabajo:
PerplexityBot rastrea e indexa páginas para que puedan mostrarse y enlazarse en las respuestas. Respeta el archivo robots.txt y no se utiliza para el entrenamiento de modelos.
Perplexity-User visita páginas en tiempo real cuando un usuario hace una pregunta, y luego las enlaza en la respuesta. Por lo general, ignora el archivo robots.txt y no se utiliza para el entrenamiento de modelos.
El resultado es un motor diseñado para citar. Ahrefs describe a Perplexity como una herramienta diseñada para respaldar casi cada afirmación con una fuente [2], y usted mismo puede confirmarlo: hágale a Perplexity cualquier pregunta de compra y la respuesta llegará con enlaces a las fuentes numerados e integrados en el texto.
Para su contenido, eso significa que una página que Perplexity pueda leer hoy puede ser citada hoy mismo. No tiene que esperar al próximo ciclo de entrenamiento del modelo.
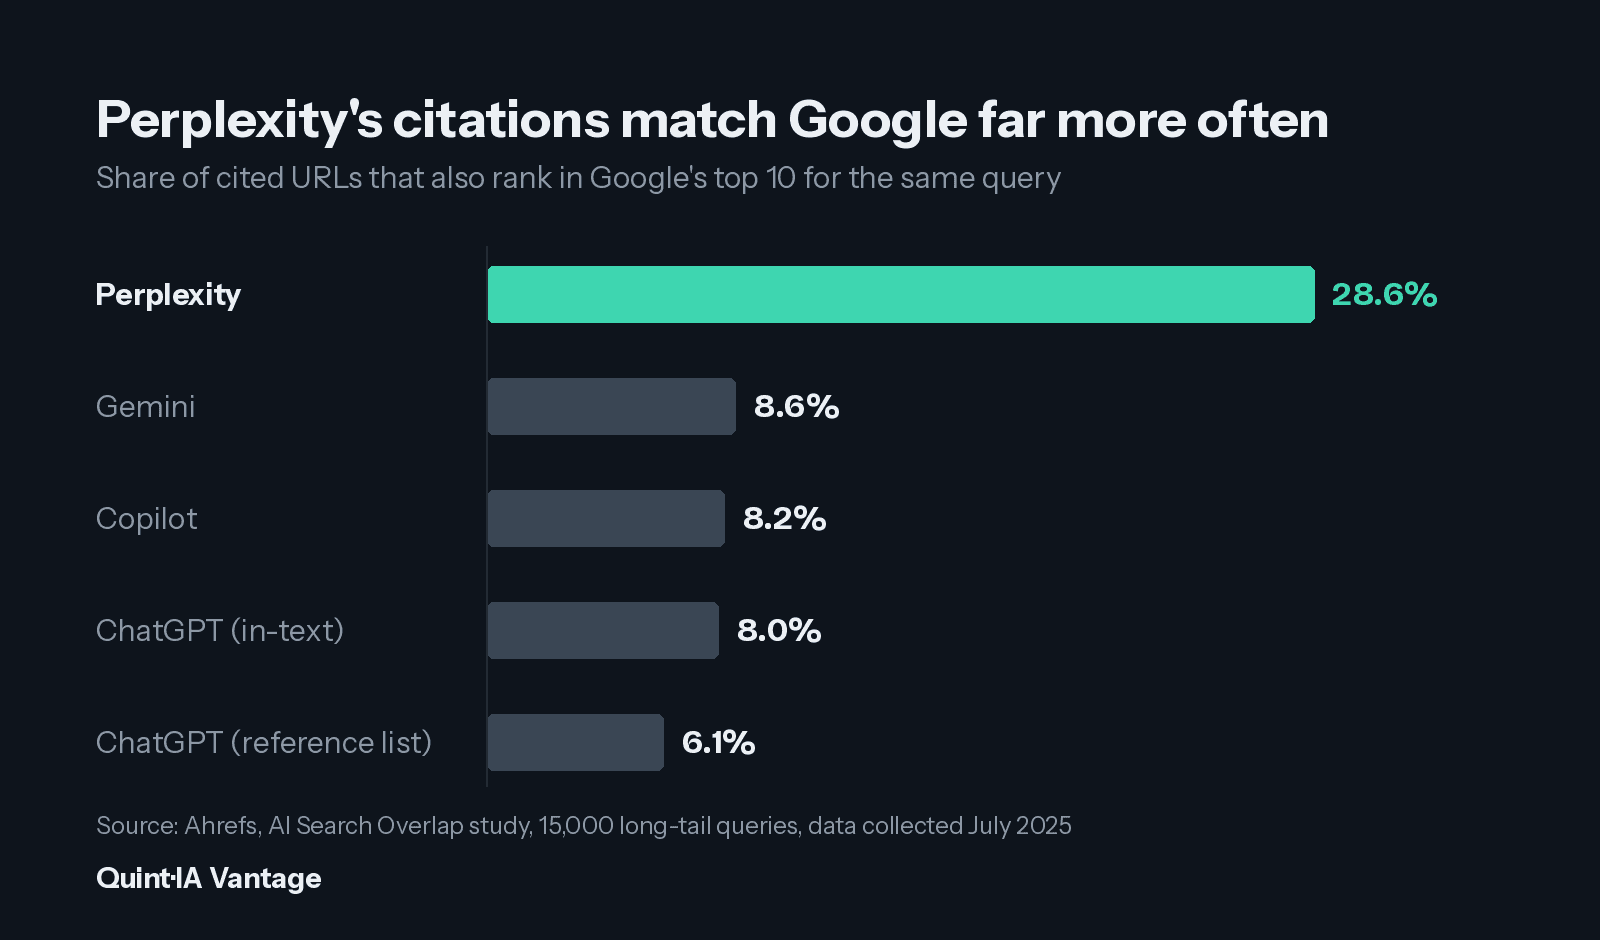
¿Qué tan alineadas están las citas de Perplexity con los rankings de Google?
Más alineadas que las de cualquier otro asistente de IA analizado por Ahrefs. En un estudio de 15.000 consultas de cola larga (long-tail) recopiladas a principios de julio de 2025, el 28,6% de las URL citadas por Perplexity también se posicionaron en el top 10 de Google para la misma consulta [2].
Los demás asistentes se situaron muy por debajo. Entre todos los asistentes de IA, solo el 12% de las citas en promedio también se posicionaron en el top 10 de Google [2].
Perplexity: 28,6%
Gemini: 8,6%
Copilot: 8,2%
ChatGPT (citas en el texto): 8,0%
ChatGPT (lista de referencias): 6,1%
La coincidencia es notable porque Perplexity no utiliza el índice de Google. Su propio rastreador llega a muchas de las mismas páginas que Google posiciona en los primeros lugares. Ahrefs relaciona esto con el diseño de Perplexity: un motor creado para citar de forma constante favorece el contenido que ya tiene un buen posicionamiento [2].
El mismo estudio reveló lo contrario para Bing. Solo el 3,3% de las citas de Perplexity coincidieron con el top 10 de Bing, el porcentaje más bajo de todos los asistentes analizados [2].
¿Qué debe hacer para recibir citas de Perplexity?
Empiece por el acceso y, a continuación, desarrolle una cobertura en torno a las preguntas que formulan sus compradores. Hay cuatro pasos que se derivan directamente de la forma en que Perplexity recupera el contenido.
1. Permita que PerplexityBot rastree su sitio. Revise el archivo robots.txt y las reglas de su CDN o firewall para asegurarse de que no bloqueen a PerplexityBot. Una página a la que el rastreador no pueda acceder no podrá mostrarse en los resultados de búsqueda de Perplexity [1].
2. Mantenga un SEO saludable en Google. Dado que el 28,6% de las citas de Perplexity también se encuentran en el top 10 de Google [2], un SEO sólido es la base para tener visibilidad en Perplexity. Si sus páginas no se posicionan para ninguna búsqueda, solucione eso primero.
3. Cubra las variaciones de cada pregunta. Ahrefs explica que los asistentes de IA amplían una sola instrucción (prompt) en varias búsquedas relacionadas (un proceso llamado